ピザラ人狼が好きだ
すべての放送回を5回ずつは見てるくらい好きだ。
毎月やってほしい。
しかしピザラ人狼をみてて思うことがある。
9人村人狼って市民側と人狼側の勝率ってどれくらいなの?
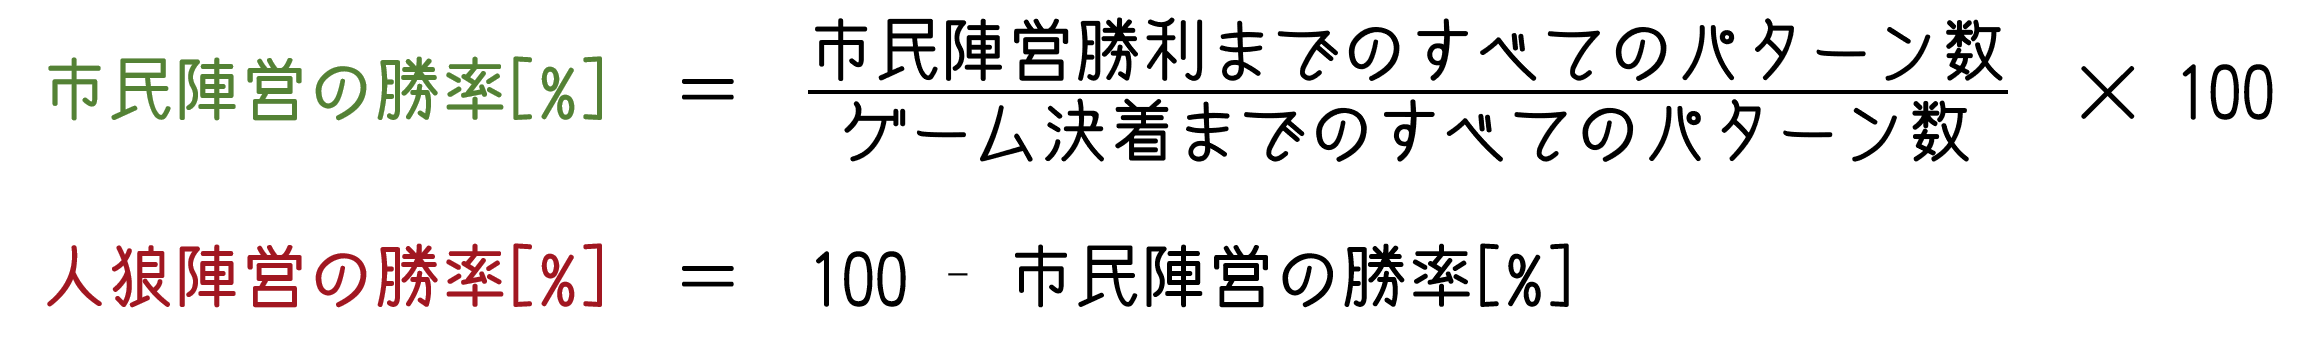
各陣営の勝率は、起こりうる「ゲーム決着までのすべてのパターン数」を数え上げて、さらに「市民陣営(もしくは人狼陣営)勝利までのすべてのパターン数」を数え上げれば、以下の式で求められる。
な~んだ、簡単じゃん!
ちゃちゃっとマクロかなんかでコード書いて数え上げたろ!
と思ってた時期がわたしにもありました。
まあ、結論から言うと100時間くらいかかりました。
これ組み合わせ爆発ってやつ? 組み合わせ爆発おねえさんなつかしい・・・
そしてPythonで全部計算してみたら、決着までのアクション履歴はまさかの40,963,022通り。
いや多すぎ。
しかも「パターン数の割合」と「完全ランダムに進んだときの勝率」は、同じ数字になりませんでした。
なぜそうなるのかも含めて、まずはピザラ人狼のルールから。
ピザラ人狼のルール
とりあえずピザラ人狼のルールの確認から。
9人村のいたってシンプルなルールで、大きく以下の通り。
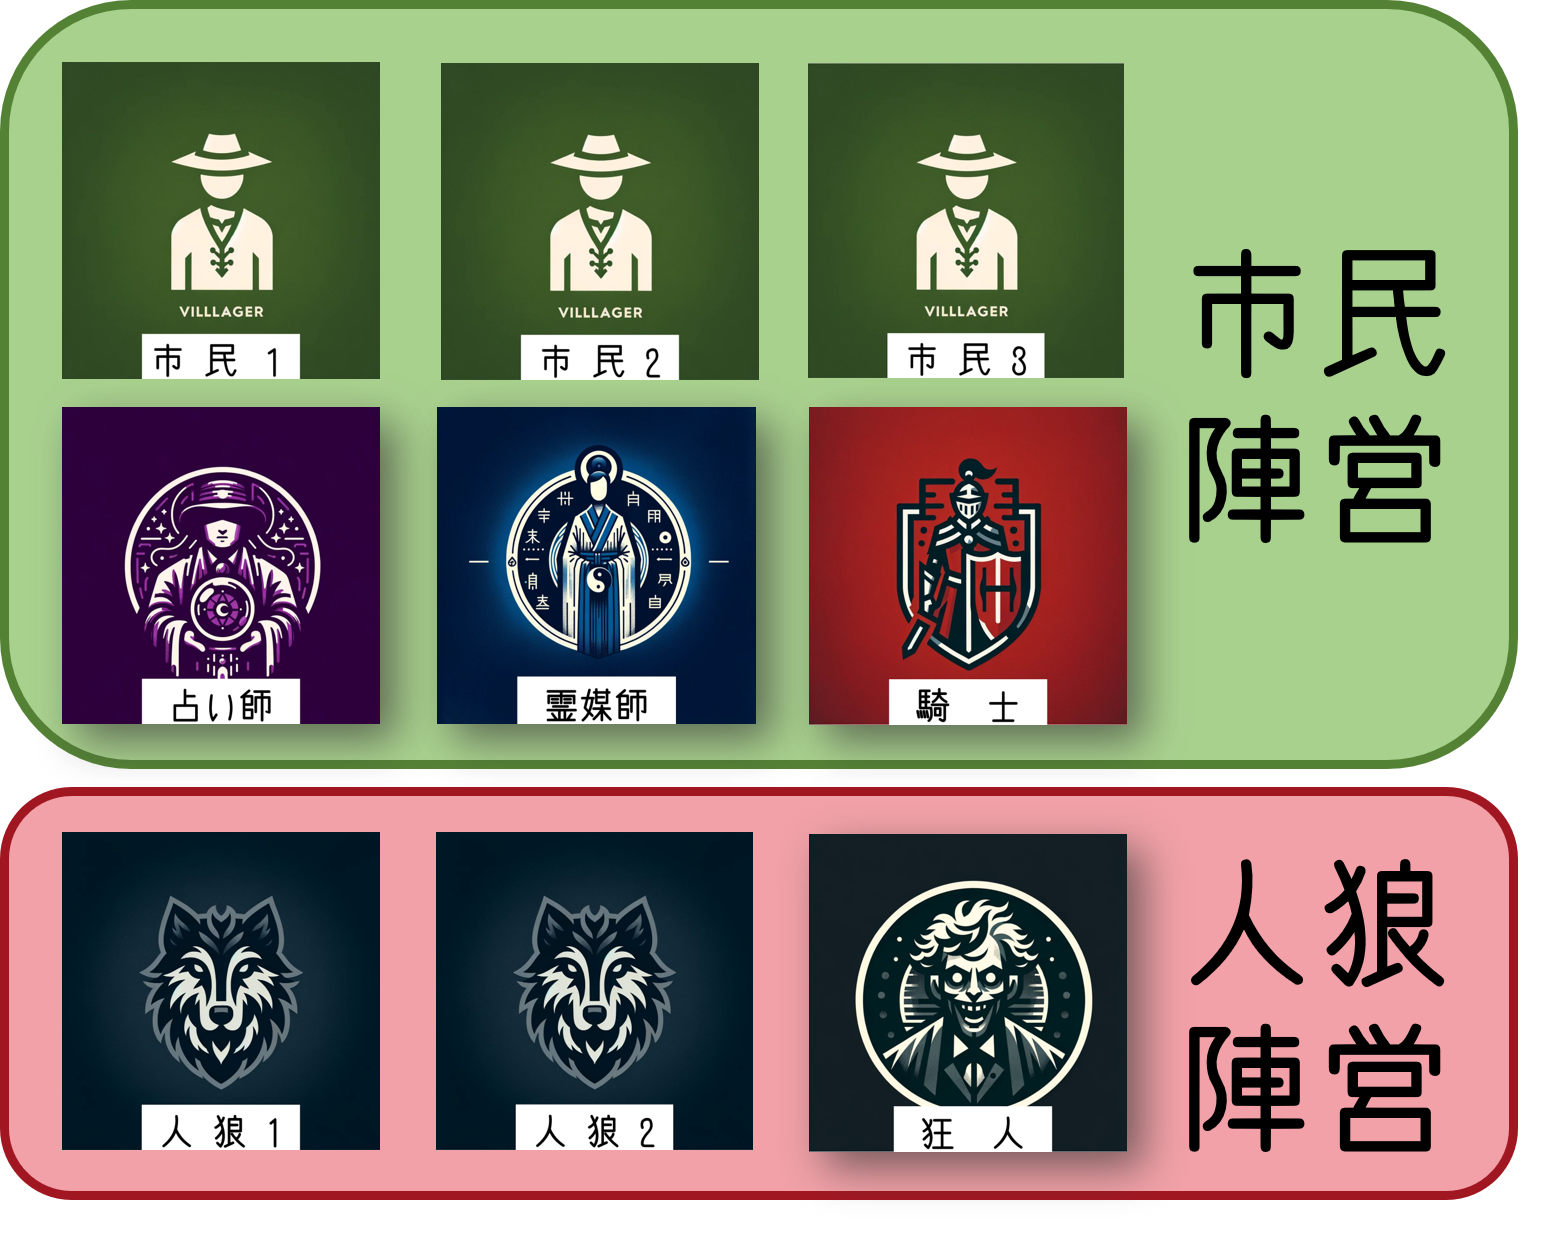
1)市民3人、占い師1人、霊媒師1人、騎士1人、人狼2人、狂人1人
| 陣営 | 役職 |
|---|---|
| 市民陣営 | 市民1・市民2・市民3・占い師・霊媒師・騎士 |
| 人狼陣営 | 人狼1・人狼2・狂人 |
勝利条件は以下の2つ。
- 生存する人狼が0人になれば市民陣営の勝利
- 生存する人狼の数が、それ以外の生存者数以上になれば人狼陣営の勝利
ちなみに狂人は人狼陣営ですが、人狼そのものではありません。
たとえば「人狼1・狂人1・市民1」の3人なら、人狼1人に対して非人狼が2人なのでゲームは続きます。
ただし投票では人狼陣営が2票持っているため、いわゆるPP盤面です。
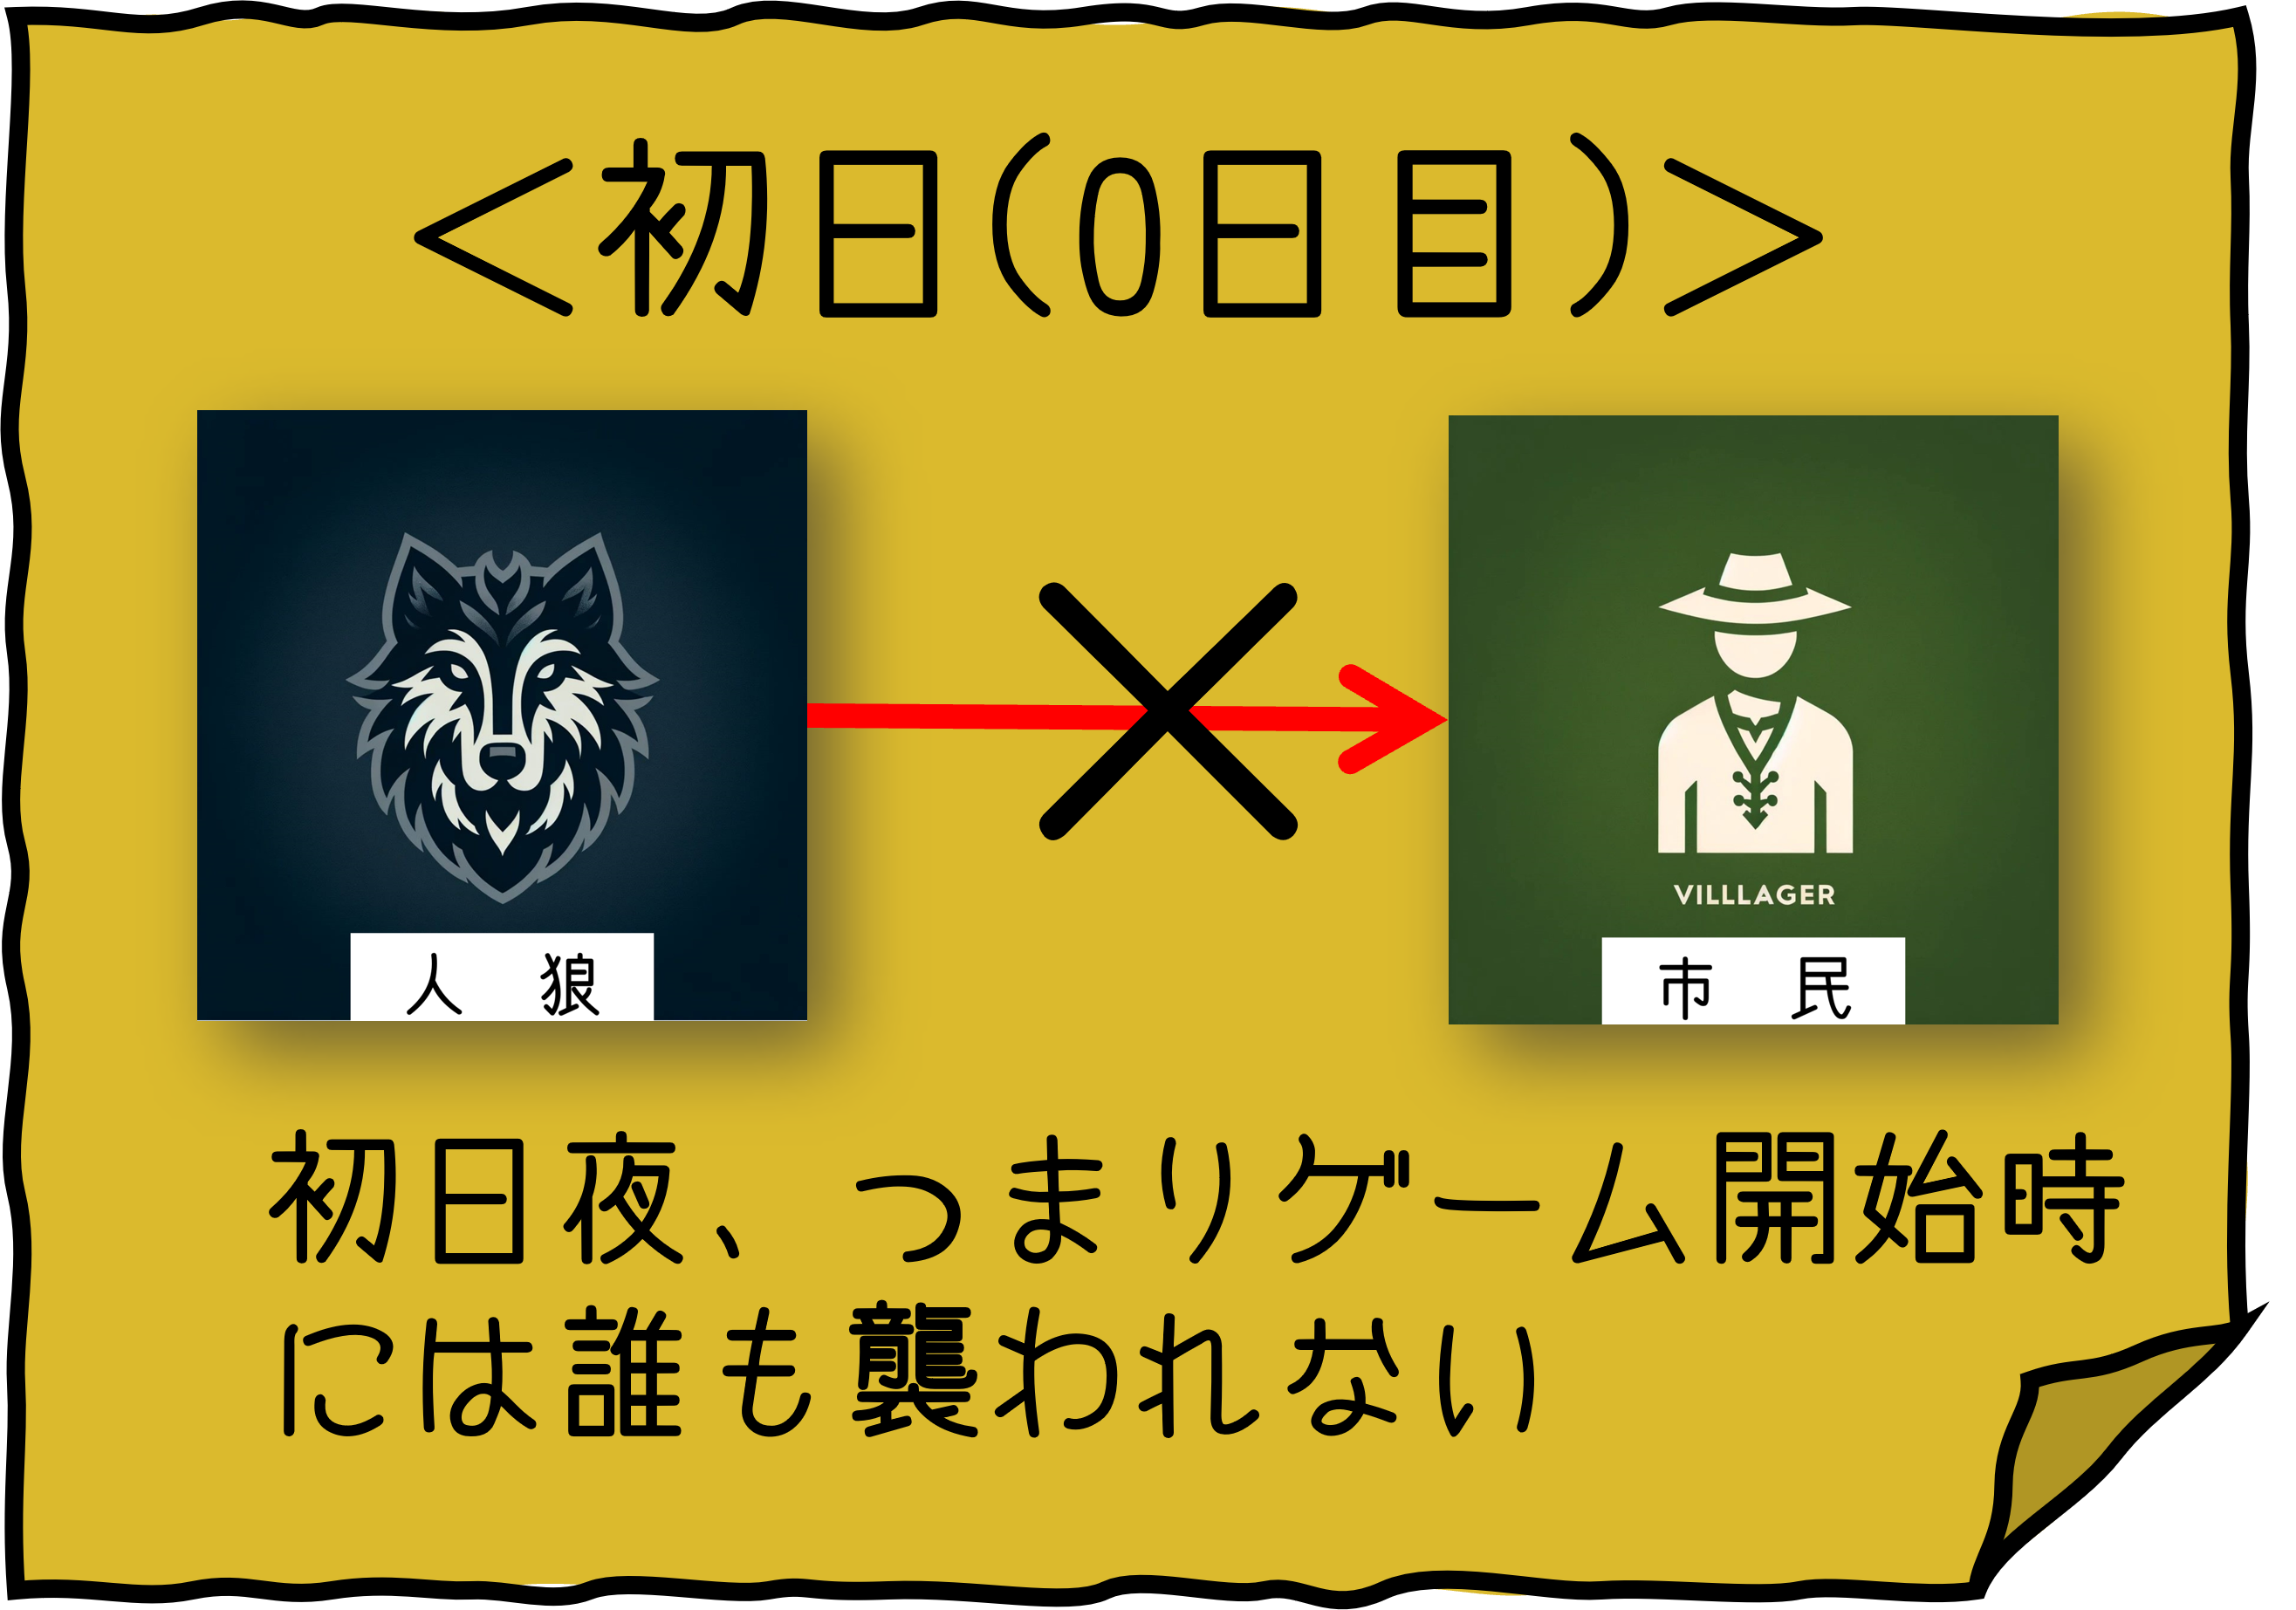
2)初日(0日目)噛みなし
ゲーム開始時点では9人全員が生存。
初日の犠牲者はいないので、いきなり昼の吊りから始まります。
3)連ガ(騎士による連続ガード)なし
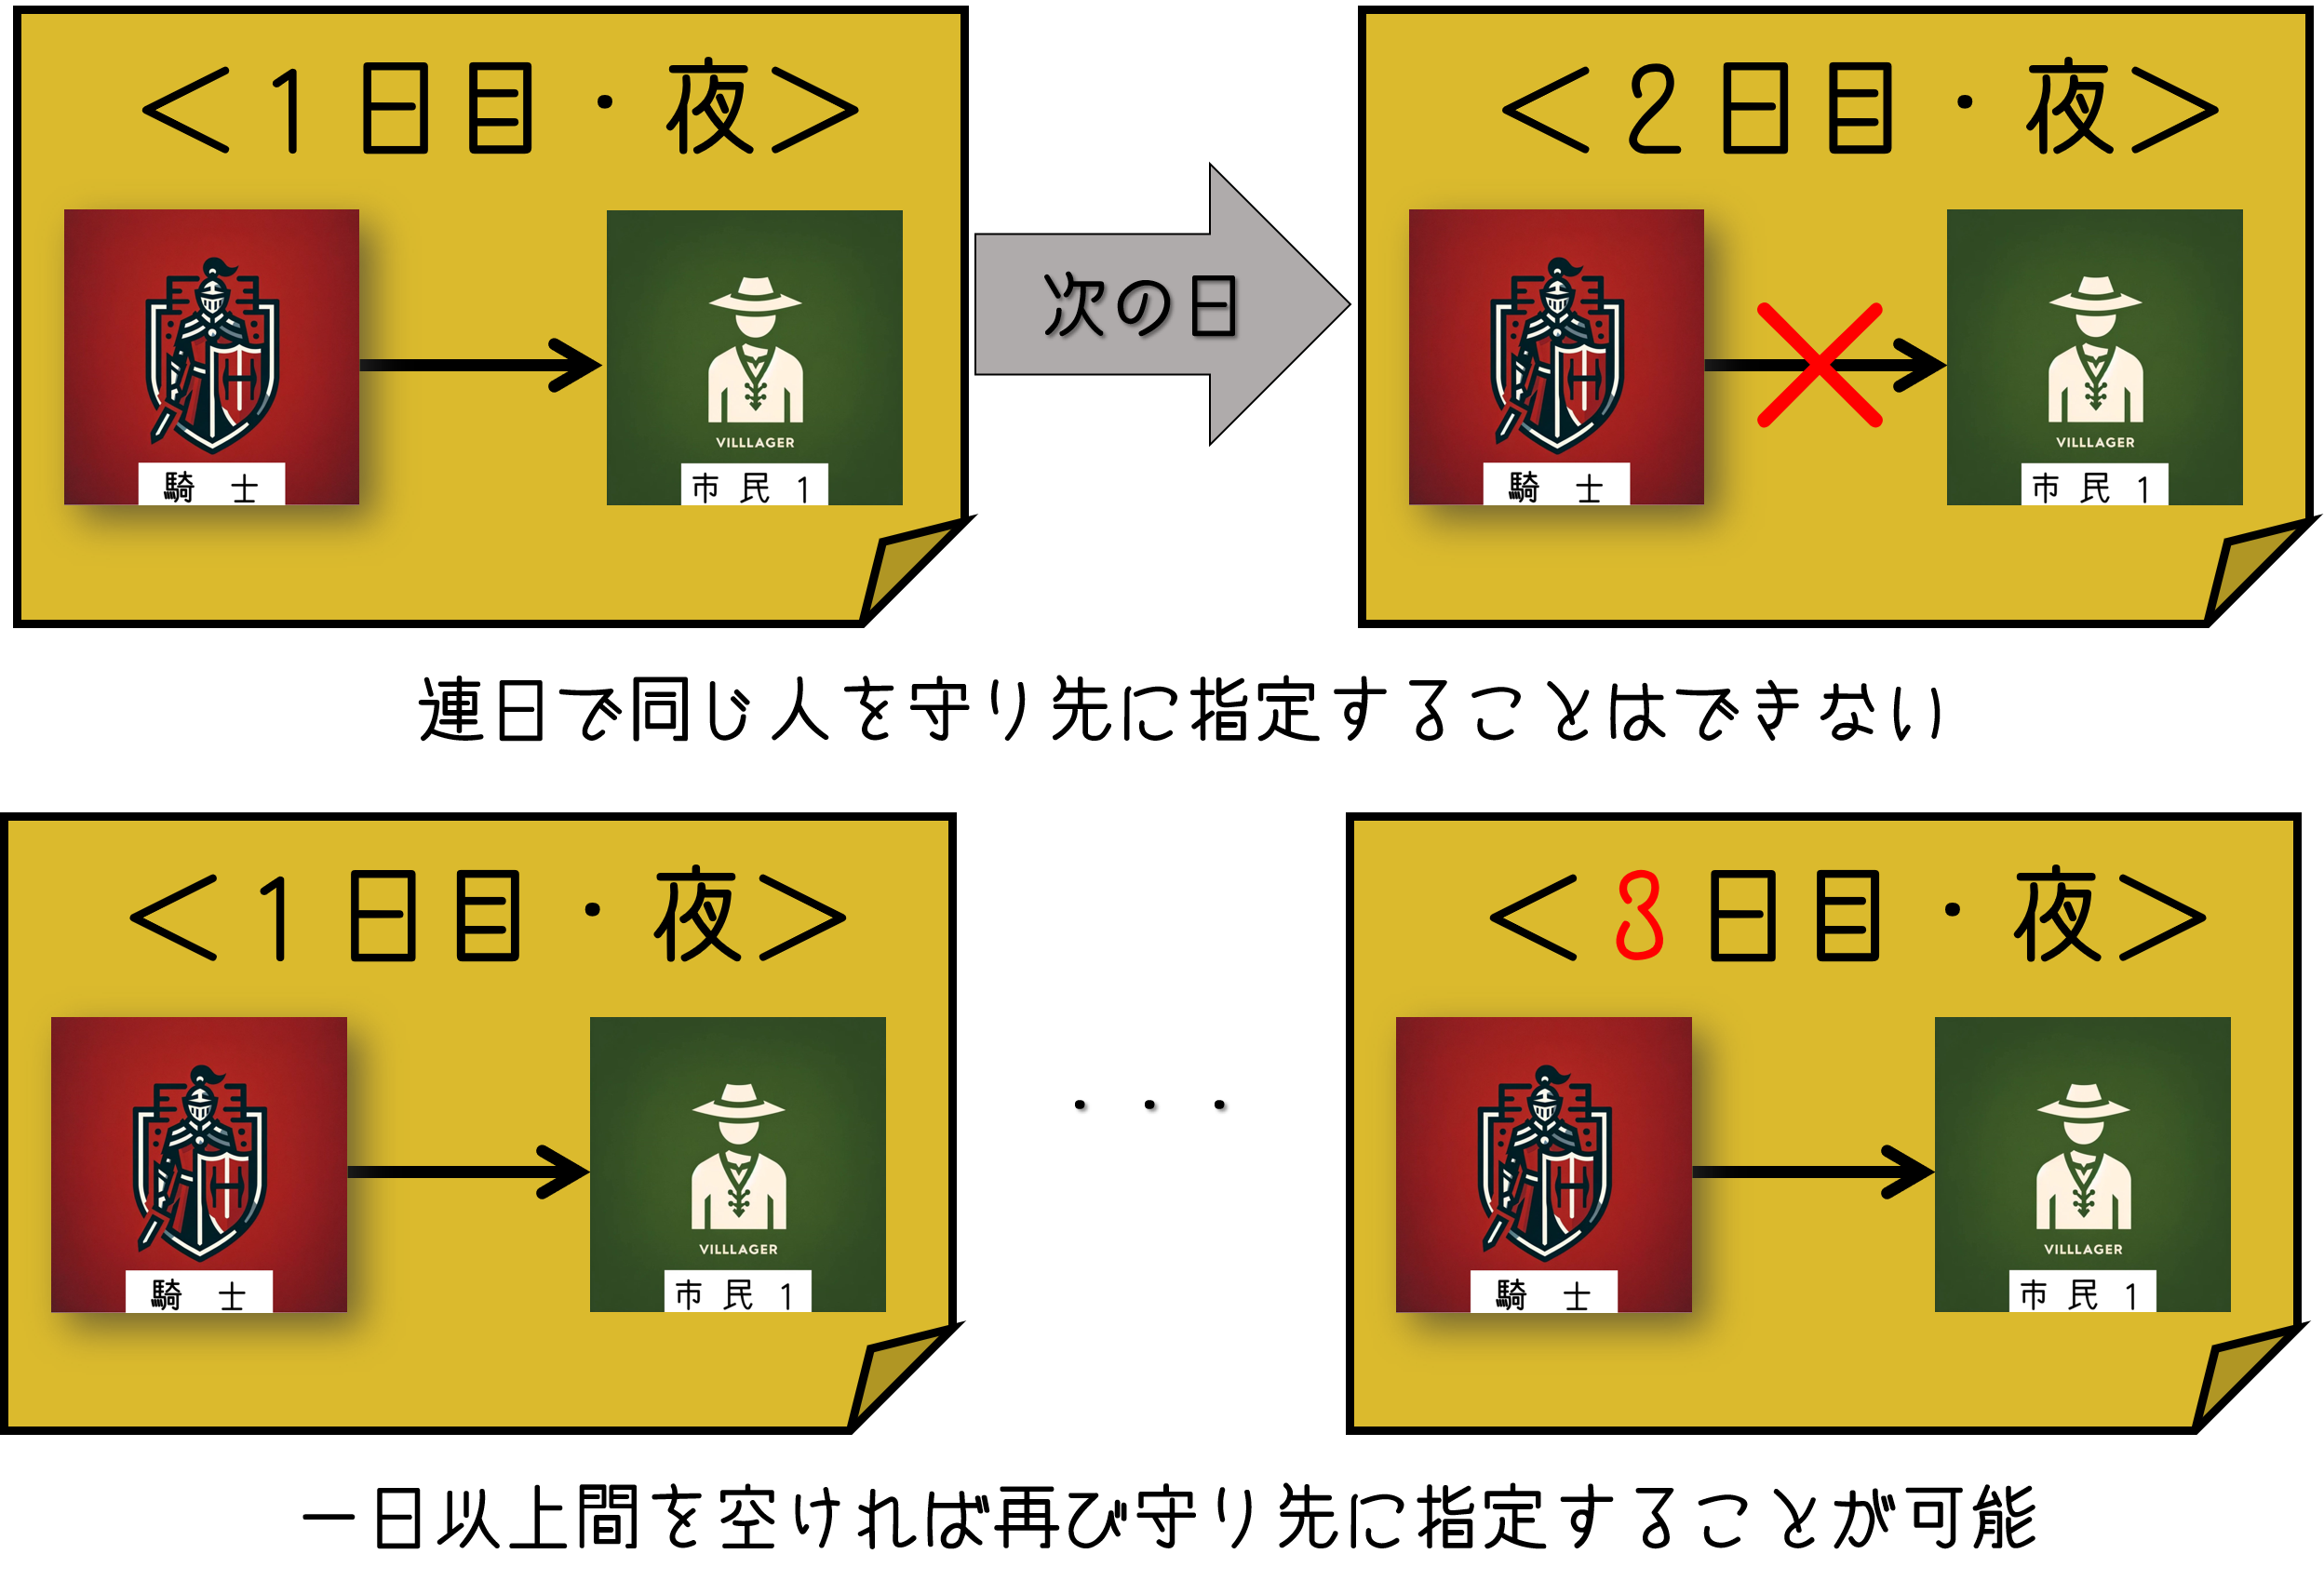
騎士は自分自身を守れません。
さらに、前日に守った相手を次の夜も続けて守ることはできません。
大きく上記3つのルールさえ把握しておけばいいかと。
数え上げるうえでとにかく「連ガなしルール」がえぐかった。
もっと正確に言うと、「GJ成功もしくは失敗」のパターンを数え上げる際に、騎士の守り先と人狼の襲撃先の組み合わせを毎回全パターン考慮する必要があります。
そのせいで、夜になるたびに組み合わせが爆増しまして・・・
さらに、それらを考慮したうえで騎士が前日守った相手を記憶しておかなければならないためにコードが複雑になりまして。(こういうのパパっとかける人尊敬します)
なんど「騎士さえいなければ・・・」と思ったか。
一応、数え上げのルールも載せときます。
数え上げのルール
大きく以下の4つのルールで、アクションごとの生き残りパターン数を数え上げます。
1)吊り先は、市民123も人狼12もその他役職もすべて区別して数え上げる
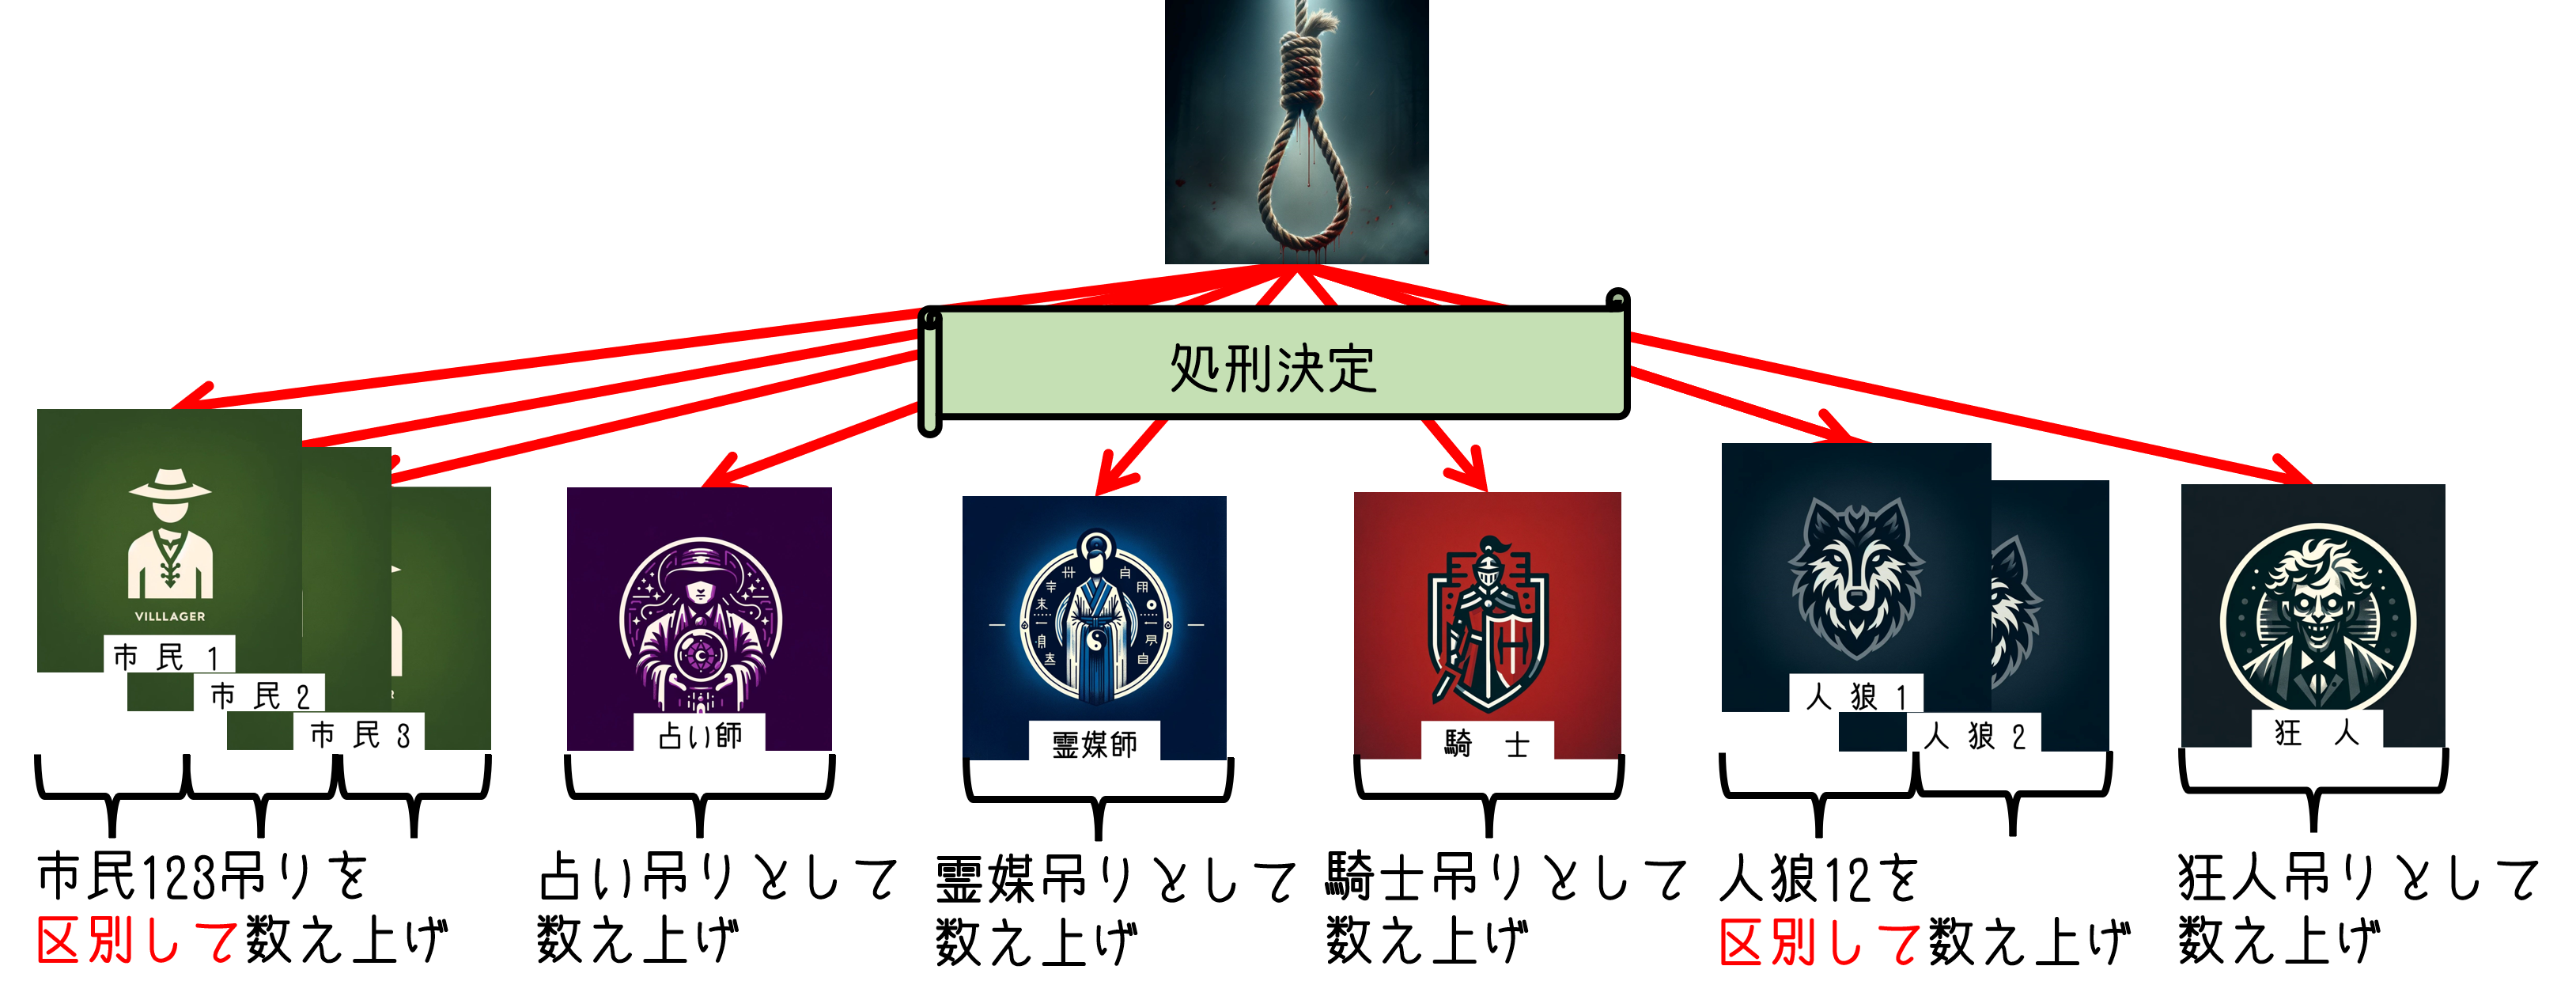
Q. 市民123、人狼12を区別する必要はあるの?
⇒A. 騎士のGJ成功・失敗、また連ガなしルールに関わってくるため、市民も人狼もその他役職も区別する必要があります。
※騎士は人狼も守れます。
たとえば前日に市民1を守っていたら、次の夜は市民1を守れません。
市民2を守っていたパターンとは次に選べる護衛先が変わるので、同じ「市民」でもまとめられないわけです。
2)人狼の襲撃対象は、すべて区別して数え上げる
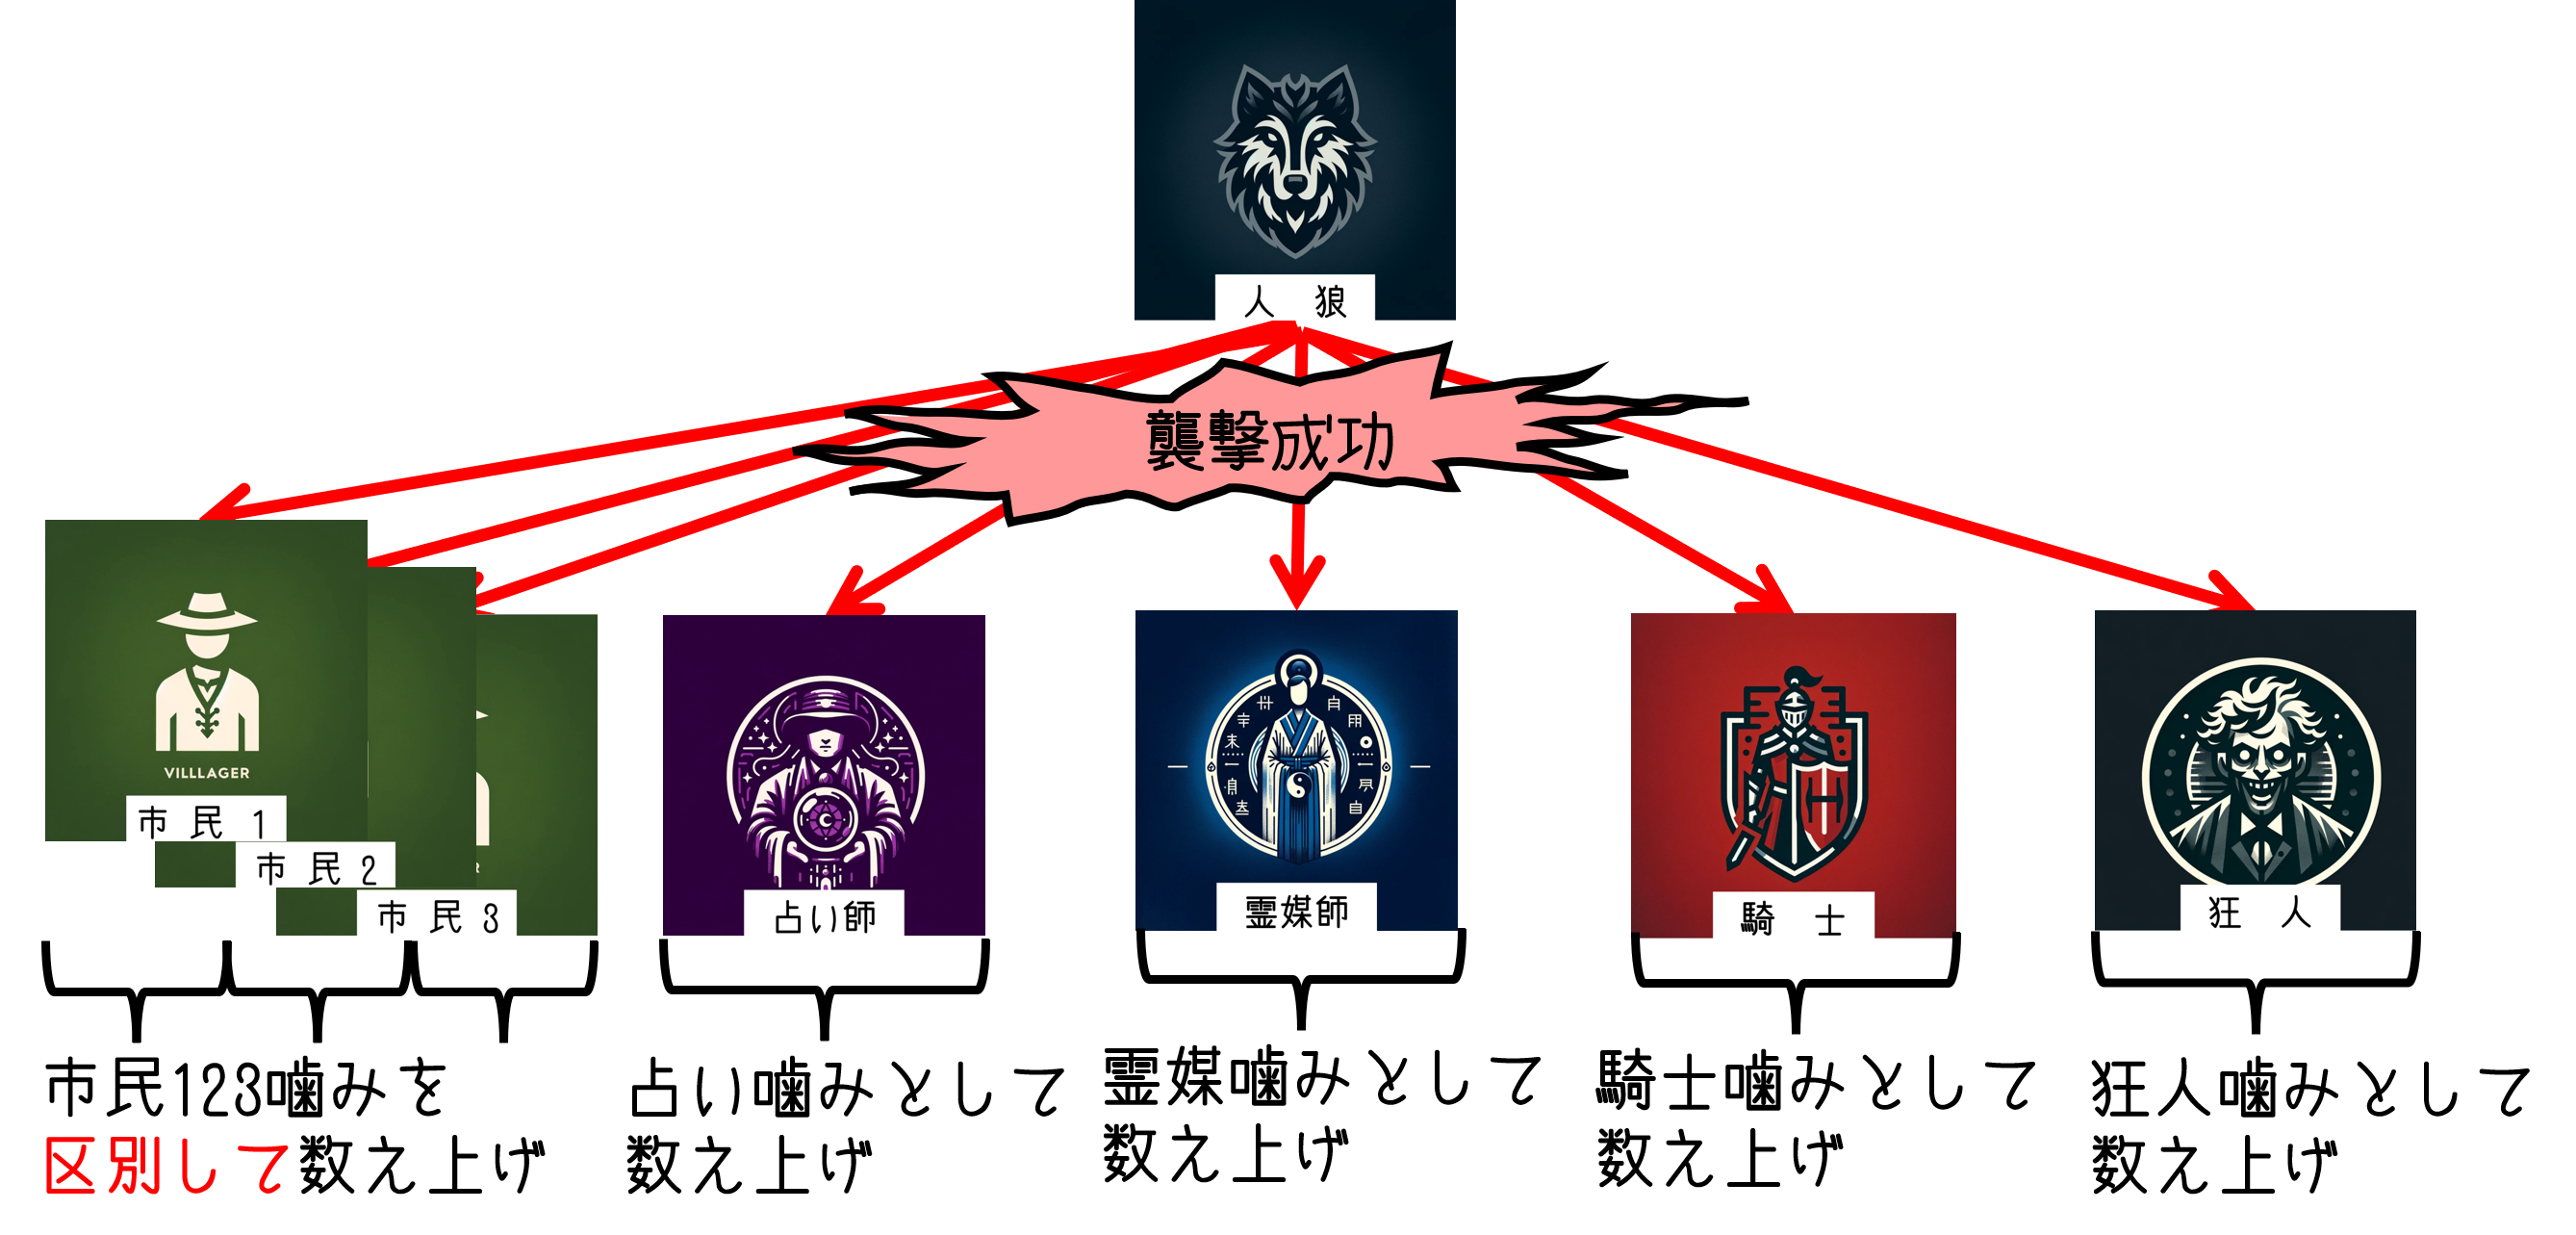
※上記1)同様、騎士に関わってくるため区別する必要があります。
※当たり前ですが、襲撃時は人狼12のどちらが噛み役だったかを区別する必要はありません。
区別するのは「誰が噛んだか」ではなく「誰を噛んだか」です。
3)騎士によるガードが成功した場合も、狼の噛み先を区別する
例)狼が市民1を襲撃したがガードされたパターンと、市民2を襲撃したがガードされたパターンを区別する。
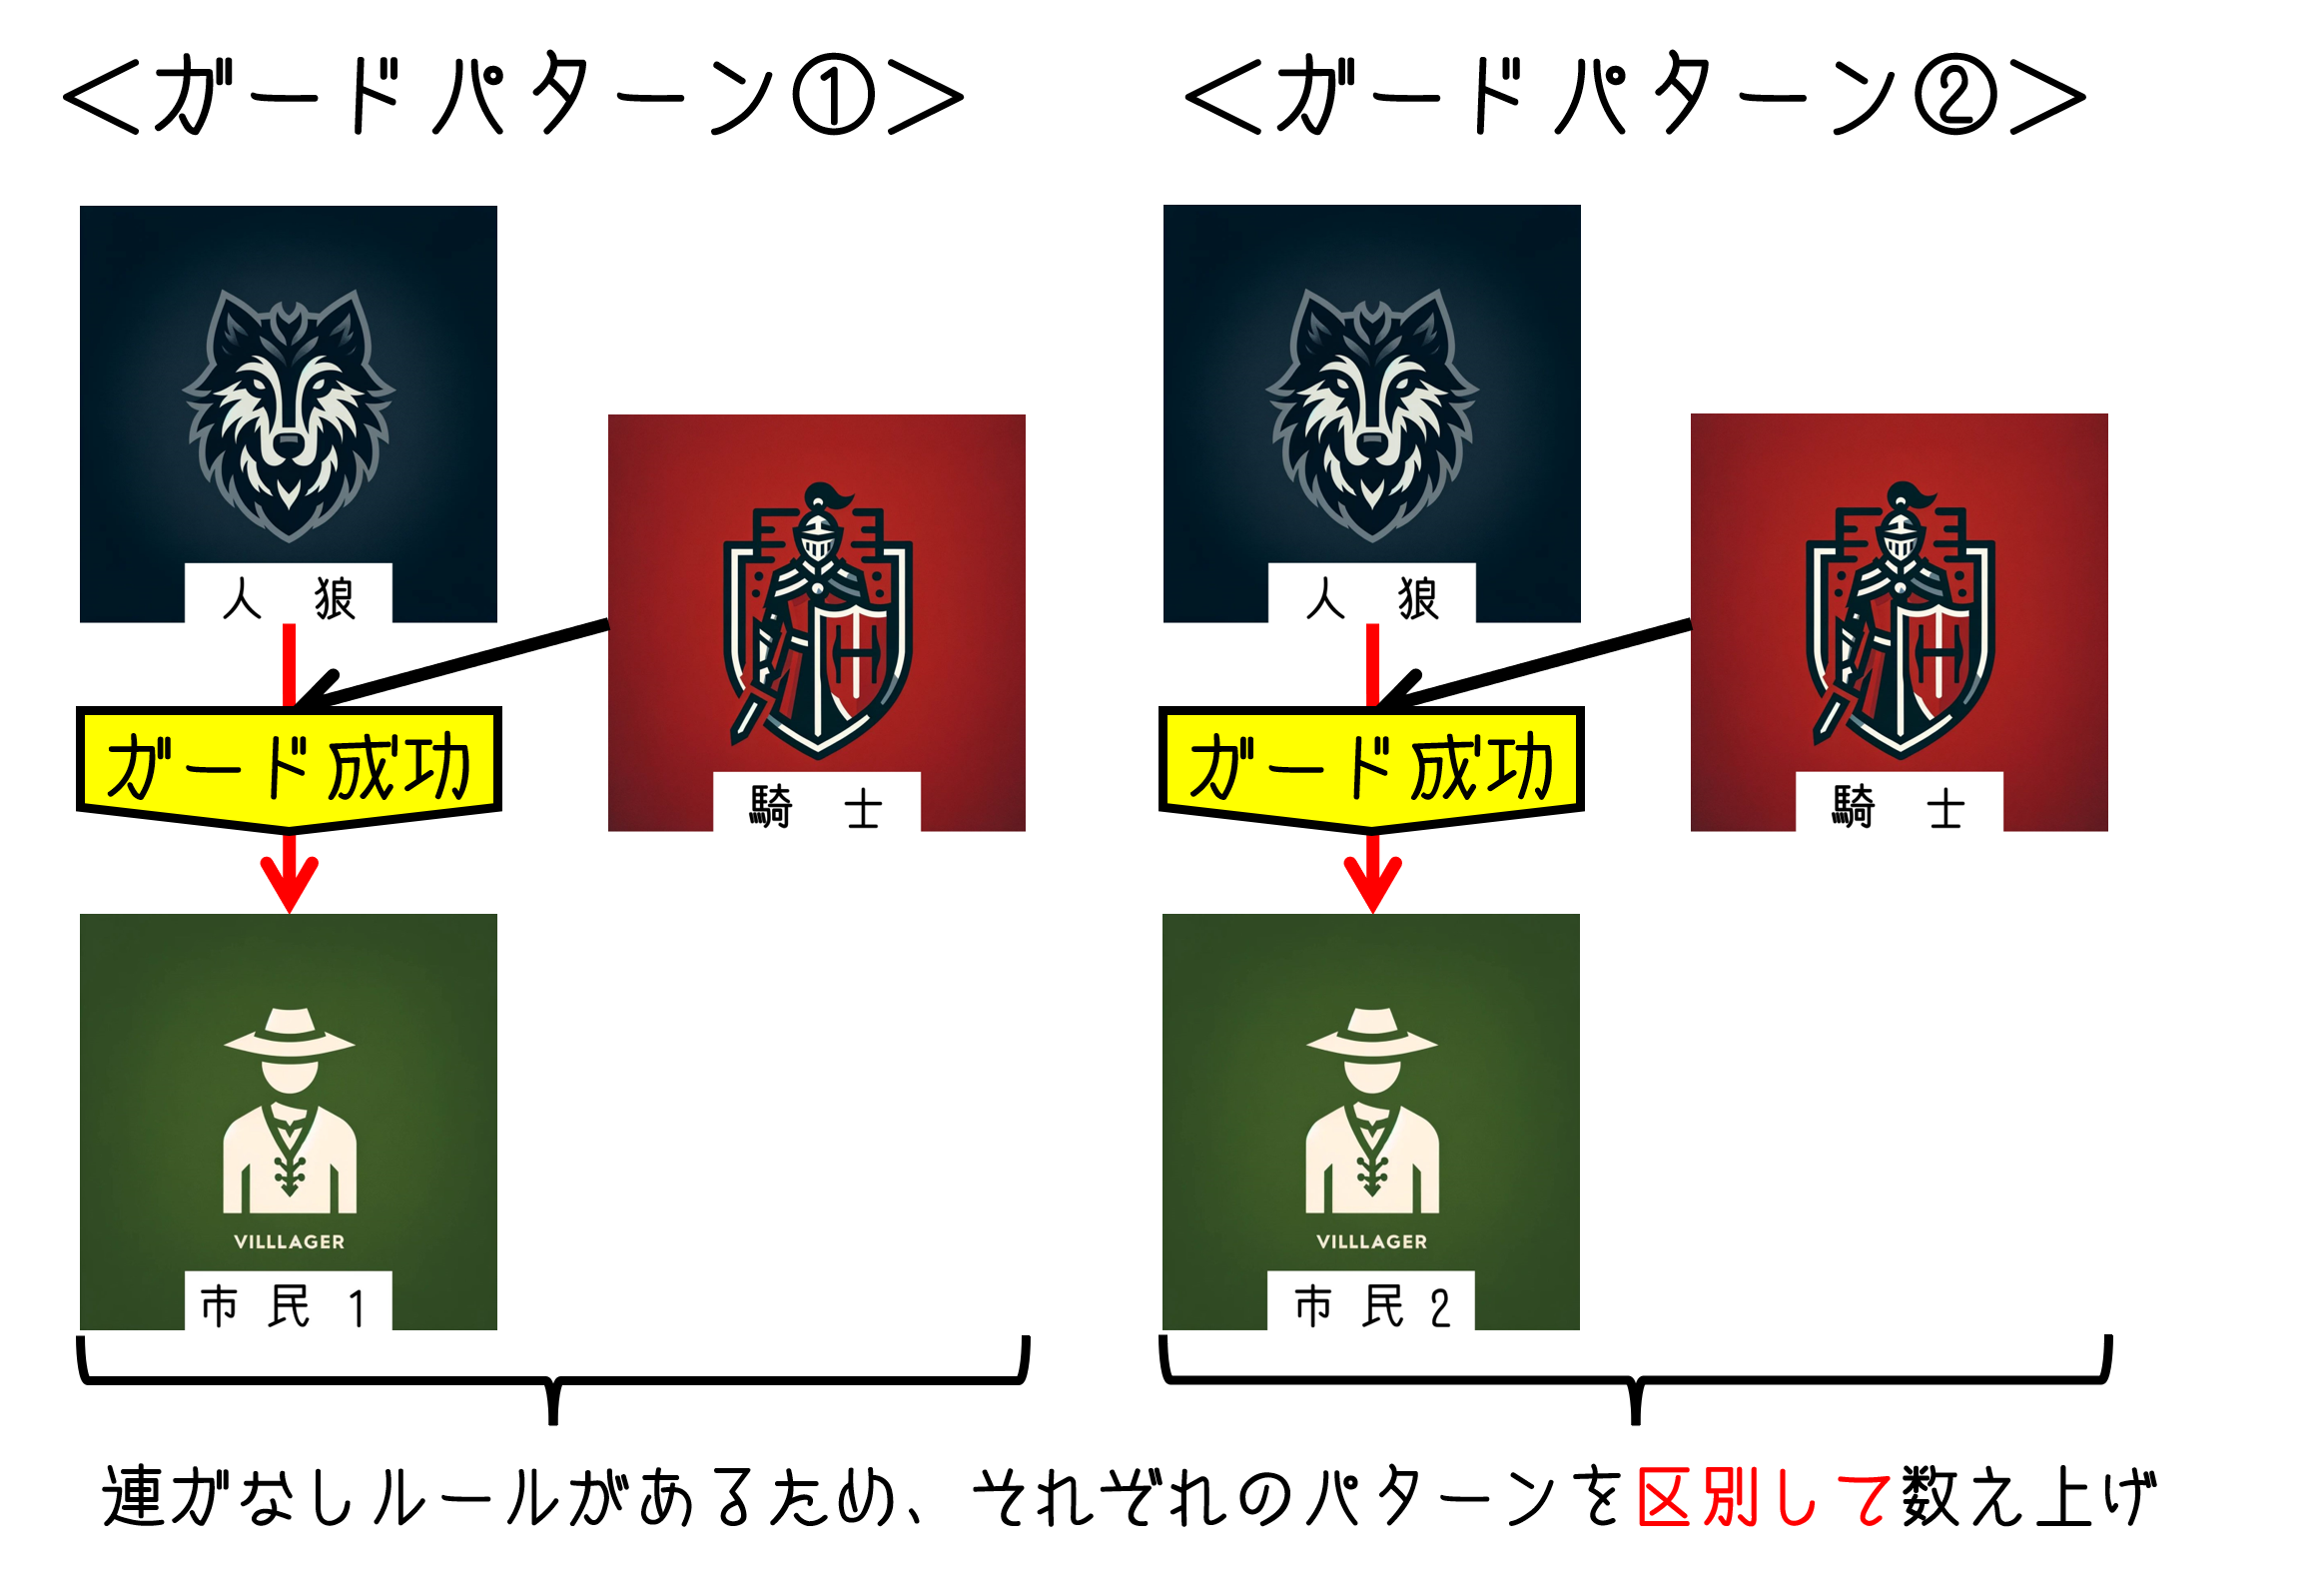
どちらも犠牲者0人ではありますが、噛み先が違うので別パターンとして数え上げます。
※上記1)、2)同様、連ガなしルールに関わってくるため区別しています。
4)上記以外のアクションは考慮しない
以下のようなアクションは考慮していません。
- 占い師が誰を占ったか
- 霊媒師が誰の結果を見たか
- 人狼陣営の役職騙りの有無・その騙り先
- 役職COの有無・そのタイミング
- 発言内容や推理
いくらでも条件分岐が作れてしまうので。
ちなみに、PPやRPP盤面であろうが、その後に起こりうるすべてのパターンを数え上げます。
つまりPP盤面であろうが、市民陣営の勝利パターンも数え上げます。
が、PPやRPP盤面の出現率もついでに出しておきます。
コードで仮定した「ランダム進行」
ここ、地味に大事です。
「全員が完全ランダムに行動する」とだけ書くと、各プレイヤーが1票ずつランダム投票するようにも見えます。
でも、それをやると同票や決選投票まで考えないといけない。
また爆発する。
なので、ランダムに選ぶ対象を以下のように決めました。
- ゲームは9人全員が生存する最初の昼から始める
- 昼は生存者の中から、最終的な吊り先1人をランダムに選ぶ
- 夜は生存している非人狼から、襲撃先1人をランダムに選ぶ
- 騎士は自分と前夜の護衛先を除く生存者から、護衛先1人をランダムに選ぶ
- 騎士は市民陣営だけでなく、人狼や狂人も護衛できる
- 襲撃先と護衛先が一致したらGJ。その夜は犠牲者なし
- 市民123、人狼12を含む9人全員を別人として区別する
つまり、1人ずつの投票行動を再現しているわけではありません。
議論と投票が終わって「誰が吊られたか」という結果だけをランダムに決めています。
ただし、コードが乱数を引いて1本だけ進むわけではありません。
選べる枝は全部残します。
そのうえで、9択なら1本ずつに1/9、7択なら1本ずつに1/7の確率を割り当てて、最後に陣営ごとに足しています。
つまり全パターンを列挙しながら、ランダムに1ゲーム進めた場合の確率も分数で厳密計算するということです。
結論:勝率は市民28.91%、人狼71.09%
さて。
前置きが長くなりましたが、結果です。
決着までのアクション履歴は、全部で40,963,022通り。
そのうち市民陣営の勝利が10,423,862通り、人狼陣営の勝利が30,539,160通りでした。
市民陣営
28.906262%
ランダム選択時の勝率
人狼陣営
71.093738%
ランダム選択時の勝率
| 集計方法 | 市民陣営 | 人狼陣営 |
|---|---|---|
| 終局履歴数 | 10,423,862通り | 30,539,160通り |
| 履歴を等しく数えた比率 | 25.447004% | 74.552996% |
| 合法手を等確率で選ぶ勝率 | 28.906262% | 71.093738% |
まず、全終局パターンの内訳は、
- 市民陣営:25.447004%
- 人狼陣営:74.552996%
です。
ただし、これは「40,963,022本の末端を全部同じ重さで数えた割合」です。
記事の最初に知りたかった「このルールで1ゲーム進めたら、どちらが勝ちやすいのか」へ答えるなら、各場面の選択確率を掛けた以下の数字を使います。
- 市民陣営:28.906262%
- 人狼陣営:71.093738%
勝率としてより正確なのは、市民28.906262%・人狼71.093738%のほうです。
同じ40,963,022通りを見ているのに、市民側が3.459258ポイント増えました。
勝率2種類あるじゃん。
どういうこと?
なぜ全パターンの割合と勝率が違うのか
わたしも最初は、全パターンを数えて市民勝利の本数を割れば、そのまま勝率になると思ってました。
でも、終わり方によって途中の分岐数が違います。
たとえば、最初にAとBを2分の1で選ぶとします。
Aを選んだらその場で終了。
Bを選んだら、そこからさらに9通りに分岐。
↓ 最初にAを選ぶ:1/2
↓ 最初にBを選ぶ:1/2
↓ 9本を合計
末端数の割合A 10% / B 90%
枝の確率の合計A 50% / B 50%
B側には9本の終わり方があるので、パターン数だけで割るとAが10%、Bが90%になります。
いやいや。
最初にAとBを選ぶ確率は、どちらも2分の1です。
Bへ進んだあとの9通りは、Bが持っている50%をさらに9分割しているだけ。
この9本をAの1本と同じ重さで数えると、B側を必要以上に重く数えてしまいます。
人狼も同じで、生存人数、騎士の生死、前夜の護衛先によって、その場で選べる行動数が変わります。
なのでコードでは、以下の2種類を別々に計算しました。
paths: そこへ到達した行動履歴の本数probability: 各局面の1 ÷ 合法手数を掛け合わせた確率
確率にはPython標準ライブラリのFractionを使っています。
途中で小数にして丸めるとズレそうだったので、最後まで分数のまま計算。
乱数を何万回も引いて近似した数字ではありません。
全分岐の確率を分数のまま足した、市民勝率の厳密な値が1850348597 / 6401203200です。
桁がもう怖い。
4096万履歴をそのまま保存しない
40,963,022件の履歴を、1件ずつリストに保存していく。
そんなことをしたら、たぶんパソコンに怒られます。
よく見ると、
- 今だれが生きているか
- 前日の護衛先はだれか
- GJ・PP・RPPをすでに通ったか
が同じなら、そこから先に起こる展開も同じです。
なので同じ状態にたどり着いた履歴はまとめて、履歴数と確率だけを足しました。
結果、実際に処理する状態は6,551個で済みました。
4096万から6551。
すごい減った。
昼の処理だけ抜き出すと、だいたい以下のような形です。
targets = execution_targets(state)
for target in targets:
    child_alive = remove_player(state.alive, target)
    child_probability = mass.probability / len(targets)
    # 同じchild状態へ来た履歴数と確率を加算する
夜は、人狼の襲撃先と騎士の護衛先の全組み合わせを作ります。
GJで犠牲者が出なかった場合も、「どこを噛んで守られたか」が違えば履歴数は別に加算。
ただし、次の状態が同じならそこで合流させます。
日数別では3〜4日目の決着が大半
せっかくなので、何日目に決着するかも出してみました。
| 決着日 | 市民勝利 | 人狼勝利 | 合計 |
|---|---|---|---|
| 2日目 | 3.126012% | 0.000000% | 3.126012% |
| 3日目 | 7.913913% | 33.213341% | 41.127254% |
| 4日目 | 16.993443% | 36.078598% | 53.072041% |
| 5日目 | 0.862271% | 1.780261% | 2.642532% |
| 6日目 | 0.010591% | 0.021473% | 0.032064% |
| 7日目 | 0.000032% | 0.000065% | 0.000097% |
3日目までに44.253266%。
4日目までなら97.325307%が決着します。
ほぼ3~4日目で終わる。
6日目以降まで続くのは、GJで夜の犠牲者が出ない展開が重なったごく一部です。
最長は7日目の昼まで。
GJ・PP・RPPになる確率
勝敗だけではもったいないので、GJ・PP・RPPの出現率も出してみました。
ゲーム中に1回以上その状態を通る確率です。
| 状態 | 確率 |
|---|---|
| GJ成功 | 22.389375% |
| PP盤面 | 28.248539% |
| RPP盤面 | 8.781598% |
GJは約22%。
5回やったら1回くらいは起こる計算。
PPは、生存している人狼陣営の票数が市民陣営より多い昼。
RPPは、両陣営の票数が同じ昼として数えています。
実際のPPなら人狼陣営は連携しますが、この計算では吊り先もランダム。
なのでPPから市民陣営が勝つパターンも、そのまま最後まで数えています。
Pythonコード全文
せっかくなので、Pythonコードも全文載せておきます。
同じ沼に入りたい人はどうぞ。
Python 3.10以降なら、追加ライブラリは不要です。
下のコードをpizzala_werewolf_analysis.pyとして保存して、以下のコマンドで実行できます。
python pizzala_werewolf_analysis.py実行すると、終局履歴数、2種類の陣営比率、GJ・PP・RPP確率、処理した状態数が表示されます。
コードが長いので、読みたい人だけ開いてください。
Pythonコード全文を開く
"""ピザラ人狼9人村の簡略ランダムモデルを厳密計算する。

昼の処刑先、夜の襲撃先、騎士の護衛先を、それぞれ合法候補から
等確率で選ぶ。会話、投票、占い・霊媒結果、役職COはモデル化しない。
"""

from __future__ import annotations

import argparse
import json
from collections import defaultdict
from dataclasses import dataclass
from fractions import Fraction
from itertools import product
from pathlib import Path
from typing import Iterable, Optional


MODEL_VERSION = "1.0.0"

PLAYERS = (
    "citizen_1",
    "citizen_2",
    "citizen_3",
    "seer",
    "medium",
    "knight",
    "werewolf_1",
    "werewolf_2",
    "madman",
)

CITIZEN_1, CITIZEN_2, CITIZEN_3, SEER, MEDIUM, KNIGHT, WEREWOLF_1, WEREWOLF_2, MADMAN = range(9)
WEREWOLVES = frozenset((WEREWOLF_1, WEREWOLF_2))
WEREWOLF_MASK = sum(1 << player for player in WEREWOLVES)
ALL_ALIVE = (1 << len(PLAYERS)) - 1

VILLAGE = "village"
WOLF = "wolf"
PP = "pp"
RPP = "rpp"


@dataclass(frozen=True)
class State:
    """同じ盤面へ合流した履歴をまとめるための状態。"""

    alive: int
    previous_guard: Optional[int] = None
    seen_gj: bool = False
    seen_pp: bool = False
    seen_rpp: bool = False


@dataclass
class Mass:
    """ある状態へ到達した履歴数と確率質量。"""

    paths: int = 0
    probability: Fraction = Fraction(0, 1)

    def add(self, paths: int, probability: Fraction) -> None:
        self.paths += paths
        self.probability += probability


@dataclass(frozen=True)
class Analysis:
    terminal_paths: dict[str, int]
    terminal_probability: dict[str, Fraction]
    finish_paths: dict[tuple[int, str, str], int]
    finish_probability: dict[tuple[int, str, str], Fraction]
    event_paths: dict[str, int]
    event_probability: dict[str, Fraction]
    board_paths_by_day: dict[tuple[int, str], int]
    board_probability_by_day: dict[tuple[int, str], Fraction]
    day_state_count: dict[int, int]
    night_state_count: dict[int, int]


def is_alive(alive: int, player: int) -> bool:
    return bool(alive & (1 << player))


def living_players(alive: int) -> tuple[int, ...]:
    return tuple(player for player in range(len(PLAYERS)) if is_alive(alive, player))


def remove_player(alive: int, player: int) -> int:
    return alive & ~(1 << player)


def living_werewolf_count(alive: int) -> int:
    return (alive & WEREWOLF_MASK).bit_count()


def winner(alive: int) -> Optional[str]:
    """人狼全滅、または人狼数が非人狼数以上なら勝敗を返す。"""

    werewolves = living_werewolf_count(alive)
    if werewolves == 0:
        return VILLAGE

    non_werewolves = alive.bit_count() - werewolves
    if werewolves >= non_werewolves:
        return WOLF
    return None


def power_play_board(alive: int) -> Optional[str]:
    """昼開始時の投票人数からPP/RPPを判定する。"""

    if winner(alive) is not None:
        return None
    werewolves = living_werewolf_count(alive)
    if werewolves == 0 or not is_alive(alive, MADMAN):
        return None

    wolf_team_votes = werewolves + 1  # 生存している狂人
    village_team_votes = alive.bit_count() - wolf_team_votes
    if wolf_team_votes > village_team_votes:
        return PP
    if wolf_team_votes == village_team_votes:
        return RPP
    return None


def mark_day_events(state: State) -> State:
    board = power_play_board(state.alive)
    return State(
        alive=state.alive,
        previous_guard=state.previous_guard,
        seen_gj=state.seen_gj,
        seen_pp=state.seen_pp or board == PP,
        seen_rpp=state.seen_rpp or board == RPP,
    )


def execution_targets(state: State) -> tuple[int, ...]:
    return living_players(state.alive)


def attack_targets(state: State) -> tuple[int, ...]:
    return tuple(player for player in living_players(state.alive) if player not in WEREWOLVES)


def guard_targets(state: State) -> tuple[Optional[int], ...]:
    if not is_alive(state.alive, KNIGHT):
        return (None,)
    return tuple(
        player
        for player in living_players(state.alive)
        if player != KNIGHT and player != state.previous_guard
    )


def add_mass(frontier: dict[State, Mass], state: State, paths: int, probability: Fraction) -> None:
    frontier.setdefault(state, Mass()).add(paths, probability)


def analyze() -> Analysis:
    """全ての合法な行動履歴を動的計画法で集計する。"""

    terminal_paths = {VILLAGE: 0, WOLF: 0}
    terminal_probability = {VILLAGE: Fraction(0, 1), WOLF: Fraction(0, 1)}
    finish_paths: dict[tuple[int, str, str], int] = defaultdict(int)
    finish_probability: dict[tuple[int, str, str], Fraction] = defaultdict(Fraction)
    event_paths = {"gj": 0, PP: 0, RPP: 0}
    event_probability = {"gj": Fraction(0, 1), PP: Fraction(0, 1), RPP: Fraction(0, 1)}
    board_paths_by_day: dict[tuple[int, str], int] = defaultdict(int)
    board_probability_by_day: dict[tuple[int, str], Fraction] = defaultdict(Fraction)
    day_state_count: dict[int, int] = {}
    night_state_count: dict[int, int] = {}

    initial = mark_day_events(State(alive=ALL_ALIVE))
    day_frontier: dict[State, Mass] = {initial: Mass(paths=1, probability=Fraction(1, 1))}
    day = 1

    def record_terminal(
        outcome: str,
        stage: str,
        state: State,
        paths: int,
        probability: Fraction,
    ) -> None:
        terminal_paths[outcome] += paths
        terminal_probability[outcome] += probability
        finish_paths[(day, stage, outcome)] += paths
        finish_probability[(day, stage, outcome)] += probability
        for event, seen in (("gj", state.seen_gj), (PP, state.seen_pp), (RPP, state.seen_rpp)):
            if seen:
                event_paths[event] += paths
                event_probability[event] += probability

    while day_frontier:
        if day > len(PLAYERS):
            raise RuntimeError("解析が想定日数内に収束しませんでした")

        day_state_count[day] = len(day_frontier)
        night_frontier: dict[State, Mass] = {}

        for state, mass in day_frontier.items():
            board = power_play_board(state.alive)
            if board is not None:
                board_paths_by_day[(day, board)] += mass.paths
                board_probability_by_day[(day, board)] += mass.probability

            targets = execution_targets(state)
            action_probability = Fraction(1, len(targets))
            for target in targets:
                child_alive = remove_player(state.alive, target)
                child = State(
                    alive=child_alive,
                    previous_guard=state.previous_guard if is_alive(child_alive, KNIGHT) else None,
                    seen_gj=state.seen_gj,
                    seen_pp=state.seen_pp,
                    seen_rpp=state.seen_rpp,
                )
                branch_probability = mass.probability * action_probability
                outcome = winner(child_alive)
                if outcome is not None:
                    record_terminal(outcome, "after_execution", child, mass.paths, branch_probability)
                else:
                    add_mass(night_frontier, child, mass.paths, branch_probability)

        night_state_count[day] = len(night_frontier)
        next_day_frontier: dict[State, Mass] = {}

        for state, mass in night_frontier.items():
            attacks = attack_targets(state)
            guards = guard_targets(state)
            actions: Iterable[tuple[int, Optional[int]]] = product(attacks, guards)
            action_count = len(attacks) * len(guards)
            action_probability = Fraction(1, action_count)

            for attack, guard in actions:
                guarded = guard is not None and attack == guard
                child_alive = state.alive if guarded else remove_player(state.alive, attack)
                child = State(
                    alive=child_alive,
                    previous_guard=guard if is_alive(child_alive, KNIGHT) else None,
                    seen_gj=state.seen_gj or guarded,
                    seen_pp=state.seen_pp,
                    seen_rpp=state.seen_rpp,
                )
                branch_probability = mass.probability * action_probability
                outcome = winner(child_alive)
                if outcome is not None:
                    record_terminal(outcome, "after_night", child, mass.paths, branch_probability)
                else:
                    add_mass(next_day_frontier, mark_day_events(child), mass.paths, branch_probability)

        day_frontier = next_day_frontier
        day += 1

    if terminal_probability[VILLAGE] + terminal_probability[WOLF] != 1:
        raise AssertionError("終局確率の合計が1ではありません")
    if sum(finish_paths.values()) != sum(terminal_paths.values()):
        raise AssertionError("終局履歴数の内訳が一致しません")
    if sum(finish_probability.values(), Fraction(0, 1)) != 1:
        raise AssertionError("日別終局確率の合計が1ではありません")

    return Analysis(
        terminal_paths=terminal_paths,
        terminal_probability=terminal_probability,
        finish_paths=dict(finish_paths),
        finish_probability=dict(finish_probability),
        event_paths=event_paths,
        event_probability=event_probability,
        board_paths_by_day=dict(board_paths_by_day),
        board_probability_by_day=dict(board_probability_by_day),
        day_state_count=day_state_count,
        night_state_count=night_state_count,
    )


def fraction_json(value: Fraction) -> dict[str, object]:
    return {
        "fraction": f"{value.numerator}/{value.denominator}",
        "decimal": round(float(value), 12),
        "percent": round(float(value) * 100, 6),
    }


def result_json(analysis: Analysis) -> dict[str, object]:
    total_paths = sum(analysis.terminal_paths.values())
    history_share = {
        outcome: Fraction(paths, total_paths)
        for outcome, paths in analysis.terminal_paths.items()
    }
    finish_days = sorted({key[0] for key in analysis.finish_paths})
    finish_by_day = []
    for day in finish_days:
        row: dict[str, object] = {"day": day}
        for stage in ("after_execution", "after_night"):
            for outcome in (VILLAGE, WOLF):
                key = (day, stage, outcome)
                row[f"{stage}_{outcome}_paths"] = analysis.finish_paths.get(key, 0)
                row[f"{stage}_{outcome}_probability"] = fraction_json(
                    analysis.finish_probability.get(key, Fraction(0, 1))
                )
        finish_by_day.append(row)

    board_days = sorted({key[0] for key in analysis.board_probability_by_day})
    board_by_day = []
    for day in board_days:
        row: dict[str, object] = {"day": day}
        for board in (PP, RPP):
            key = (day, board)
            row[f"{board}_prefix_paths"] = analysis.board_paths_by_day.get(key, 0)
            row[f"{board}_probability"] = fraction_json(
                analysis.board_probability_by_day.get(key, Fraction(0, 1))
            )
        board_by_day.append(row)

    return {
        "model_version": MODEL_VERSION,
        "players": list(PLAYERS),
        "assumptions": {
            "day_execution": "uniform among all living players",
            "night_attack": "uniform among living non-werewolves",
            "knight_guard": "uniform among living players except self and previous target",
            "first_night_attack": False,
            "named_players_are_distinct": True,
            "seer_medium_discussion_and_votes": "not modeled",
        },
        "terminal_histories": {
            "total": total_paths,
            VILLAGE: analysis.terminal_paths[VILLAGE],
            WOLF: analysis.terminal_paths[WOLF],
            f"{VILLAGE}_share": fraction_json(history_share[VILLAGE]),
            f"{WOLF}_share": fraction_json(history_share[WOLF]),
        },
        "random_choice_probability": {
            VILLAGE: fraction_json(analysis.terminal_probability[VILLAGE]),
            WOLF: fraction_json(analysis.terminal_probability[WOLF]),
        },
        "events_at_least_once": {
            event: {
                "terminal_histories": analysis.event_paths[event],
                "probability": fraction_json(analysis.event_probability[event]),
            }
            for event in ("gj", PP, RPP)
        },
        "finish_by_day": finish_by_day,
        "power_play_board_by_day": board_by_day,
        "aggregated_states": {
            "day": analysis.day_state_count,
            "night": analysis.night_state_count,
            "total": sum(analysis.day_state_count.values()) + sum(analysis.night_state_count.values()),
        },
    }


def format_number(value: int) -> str:
    return f"{value:,}"


def print_text(data: dict[str, object]) -> None:
    histories = data["terminal_histories"]
    probability = data["random_choice_probability"]
    events = data["events_at_least_once"]

    print("ピザラ人狼9人村・簡略ランダムモデル")
    print(f"モデル: v{data['model_version']}")
    print()
    print("終局パターン数(行動履歴を1本ずつ数える)")
    print(f"  合計:       {format_number(histories['total'])}")
    print(
        f"  市民陣営:   {format_number(histories[VILLAGE])} "
        f"({histories[f'{VILLAGE}_share']['percent']:.6f}%)"
    )
    print(
        f"  人狼陣営:   {format_number(histories[WOLF])} "
        f"({histories[f'{WOLF}_share']['percent']:.6f}%)"
    )
    print()
    print("各局面で合法手を等確率に選ぶ場合の勝率")
    print(f"  市民陣営:   {probability[VILLAGE]['percent']:.6f}%")
    print(f"  人狼陣営:   {probability[WOLF]['percent']:.6f}%")
    print()
    print("一度以上その状態になる確率")
    print(f"  GJ成功:     {events['gj']['probability']['percent']:.6f}%")
    print(f"  PP盤面:     {events[PP]['probability']['percent']:.6f}%")
    print(f"  RPP盤面:    {events[RPP]['probability']['percent']:.6f}%")
    print()
    print(f"集約して処理した状態数: {format_number(data['aggregated_states']['total'])}")


def main() -> None:
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--format", choices=("text", "json"), default="text")
    parser.add_argument("--output", type=Path, help="同じ出力をUTF-8のファイルへ保存する")
    args = parser.parse_args()

    data = result_json(analyze())
    if args.format == "json":
        output = json.dumps(data, ensure_ascii=False, indent=2)
    else:
        output = None

    if args.output:
        args.output.parent.mkdir(parents=True, exist_ok=True)
        if output is None:
            raise SystemExit("--output は --format json と組み合わせてください")
        args.output.write_text(f"{output}\n", encoding="utf-8")

    if args.output:
        print(f"Saved analysis JSON: {args.output}")
    elif output is not None:
        print(output)
    else:
        print_text(data)


if __name__ == "__main__":
    main()
「人狼陣営が7割勝つ」という意味ではない
ここは大事なので、もう1回。
「ピザラ人狼では人狼陣営が71%勝つ」という意味ではありません。
71.093738%は、全員がここまで書いたランダムルールで動いた場合の数字です。
実際の人狼には、計算へ入れていないものが大量にあります。
- 占い師と霊媒師が得る情報
- 発言、役職CO、投票理由
- 人狼と狂人の連携
- 騎士の読み合い
- プレイヤーごとの経験差
- 同票と決選投票
むしろ、ここが人狼の面白いところかと。
占い結果ひとつ、発言ひとつで、吊り先も噛み先も全然変わります。
なのでこの記事で言えるのは、このランダムルールなら人狼陣営側に傾くということまでです。
まとめ
9人村の全パターンをPythonで数えたら、決着までのアクション履歴は40,963,022通りになりました。
いや4096万通りて。
そして、パターン数をそのまま割った割合と、各場面の選択確率を掛けた勝率は同じにならない。
完全ランダムに進めた場合の勝率は、
- 市民陣営:28.906262%
- 人狼陣営:71.093738%
という結果でした。
小数点以下まで並べるとすごく正しそうに見えますが、条件を変えれば結果も変わります。
だからこそ、何を1パターンとして、何をランダムに選んだのかをコードと一緒に残しておくのが大事かと。
とりあえず、騎士がやばい。
コメント