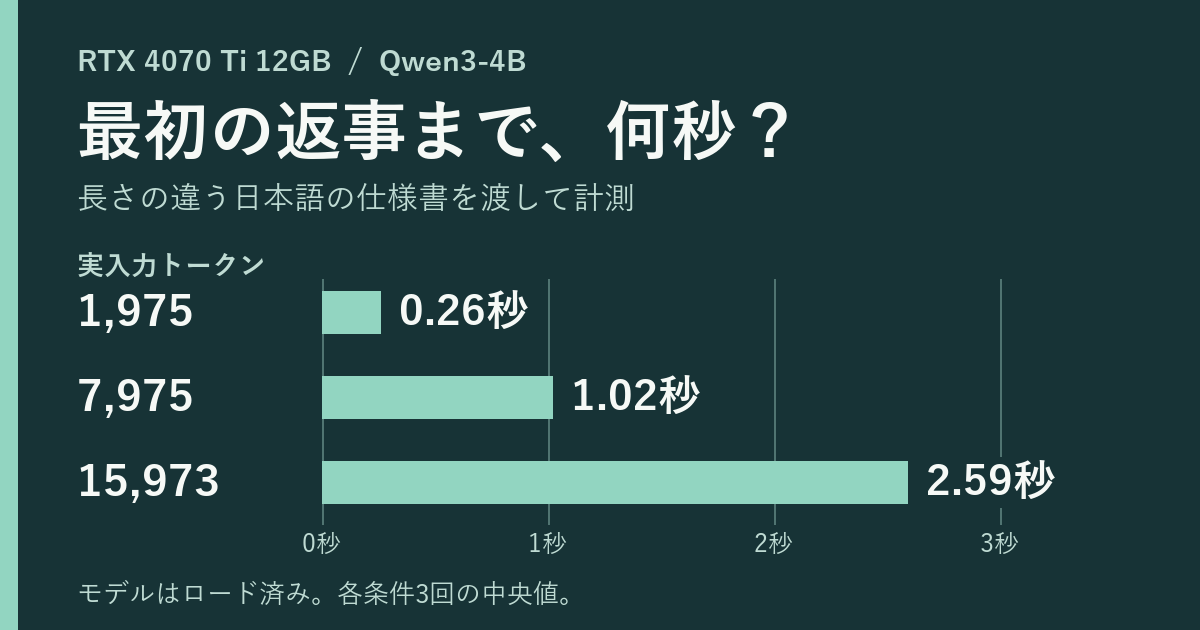
Windowsの12GB級GPUでQwen3-4Bに日本語の仕様書を渡すと、APIから最初の文字列が届くまで約2千トークンで0.26秒、約1万6千トークンで2.59秒でした。モデルはロード済みです。いずれの長さでも回答は返りましたが、仕様書にある6項目をすべて正しく拾えた回はありませんでした。
約2千・8千・1万6千トークンを各3回
GPUはRTX 4070 Ti、モデルはQwen3-4BのQ4_K_M、実行環境はllama.cpp b12359。最大コンテキスト長は20,480、出力上限は192トークン、生成温度は0にそろえました。思考モードと入力の再利用を切り、事前に短い依頼で動作を確認。3条件の順番を入れ替えて各3回測りました。 使用したモデル llama.cppの配布版
| 実入力トークン | 最初に文字列が届くまでの中央値(範囲) | 生成速度の中央値 | JSONとしてそのまま読めた回数 | 値の一致 |
|---|---|---|---|---|
| 1,975 | 0.26秒(0.24〜0.48秒) | 108.6トークン/秒 | 3/3回 | 3/6項目 |
| 7,975 | 1.02秒(1.02〜1.03秒) | 87.8トークン/秒 | 0/3回 | 3/6項目 |
| 15,973 | 2.59秒(2.58〜2.61秒) | 71.3トークン/秒 | 0/3回 | 4/6項目 |
待ち時間は、ローカルAPIにリクエストを送ってから、応答の本文が最初に届くまで。生成速度はサーバーが返した値です。右端は、JSONがコードブロックに入っていた場合に囲いを外し、中の値を採点した結果です。各条件内では3回とも同じ項目が一致しました。
GPU全体のVRAM使用量は、モデルをロードしてからの観測で全試行9,468 MiBでした。固定した最大コンテキストで起動した状態の値で、Windowsや他の処理が使う分も含みます。短い入力を送ったときにモデルだけが使った量を知るには、別の測り方が必要です。
約2千トークンでも、コード欄に隣の数値が入った
架空の設備点検システムの資料から、現行版の6項目をJSONで抜き出す課題です。受付経路コードと保留時間、台帳名と保管日数、照合コードと受付上限を、資料の前・中・後ろに2つずつ置きました。6項目の値と旧版の記述をそろえ、周りに挟む日本語の説明だけを増やしています。
たとえば、仕様書では受付経路コードが K7M4、保留時間が47分です。約2千トークンでもモデルはコード欄に隣の数値 47 を入れました。この取り違えは、約8千と1万6千トークンでも同じでした。
一方、台帳名の「楓三号」は一番長い条件でだけ一致しました。約8千と1万6千トークンでは、JSONの前後にMarkdownのコードブロックも付きました。自動処理で受け取るなら、待ち時間と、JSONとして読めるかと、中身が合っているかを分けて測ると、どこに手を入れるべきか判断できます。
手持ちの資料を試すなら、答え合わせできる項目から
自分のPCで測るときは、まず正解を知っている資料を1つ選びます。型番、期限、件数など、目視で判定できる項目を数個決め、同じモデルで短い版と長い版を比べてください。今回のように文字のコード欄へ数字が入る場合は、文字列の型を検査するだけでも、後続処理へ誤った値を渡す前に気づけます。
今回は、補足文を繰り返した架空の資料1種類での比較です。12GBの機材を選ぶときは、この表の秒数と、自分が使う資料を渡したときの結果を手掛かりにしてください。モデル別の比較が必要なら、短めの共通課題で速度と品質を測った実測表も参考になります。 RTX 4070 12GBでのモデル別実測
同じモデルをOpenCodeから呼び出すテストも行いました。ファイルが変わらないときは、モデルの返事から編集の実行記録まで順に確認できます。 OpenCodeの返事と実際のファイル編集を照合する
コメント